· ARJUN · WRITING
Agent 为什么会在新项目里用错包管理器
新项目默认用 pnpm,旧仓库仍然需要 npm ci。两条规则都没错,Agent 却在下一次创建项目时选错了工具。问题藏在 Memory 写入时丢失的作用域里。
上周,你对一个编程 Agent 说:「以后新建前端项目,默认用 pnpm。」
今天,你接手一个旧仓库,又补了一句:「这个仓库保留现有的 package-lock.json,安装依赖继续用 npm ci。」
过几天,你让 Agent 创建一个新项目。它给出的第一条命令却是 npm install。
如果这只是当前对话里的误解,重新说明一次就够了。麻烦在于,那条仓库级规则已经被写进长期记忆,替换了原来的个人偏好。之后每个新会话,都可能得到同样的错误答案。
它记住了最后一次出现的工具,却忘了那条规则只属于一个旧仓库。
上一篇文章已经拆开了 Context、Thread State 和 Long-Term Memory。这一篇只看一个更窄、也更容易落到代码里的问题:一条新信息进入 Memory 时,系统到底更新哪一条记录?
Bug 是怎么写进去的
一个过于简单的写入流程,通常长这样:
# 反例:相似就覆盖
def remember(text):
    fact = extract_fact(text)
    old = memory.search(fact, limit=1)

    if old and old.score > 0.85:
        memory.update(old.id, fact)
    else:
        memory.insert(fact)
这里的 0.85 只是示意。真正的问题不是阈值设得不够好,而是代码把「语义相似」当成了「同一条记忆」。
第二句话经过提取后,可能只剩下:
{
  "predicate": "package_manager",
  "value": "npm"
}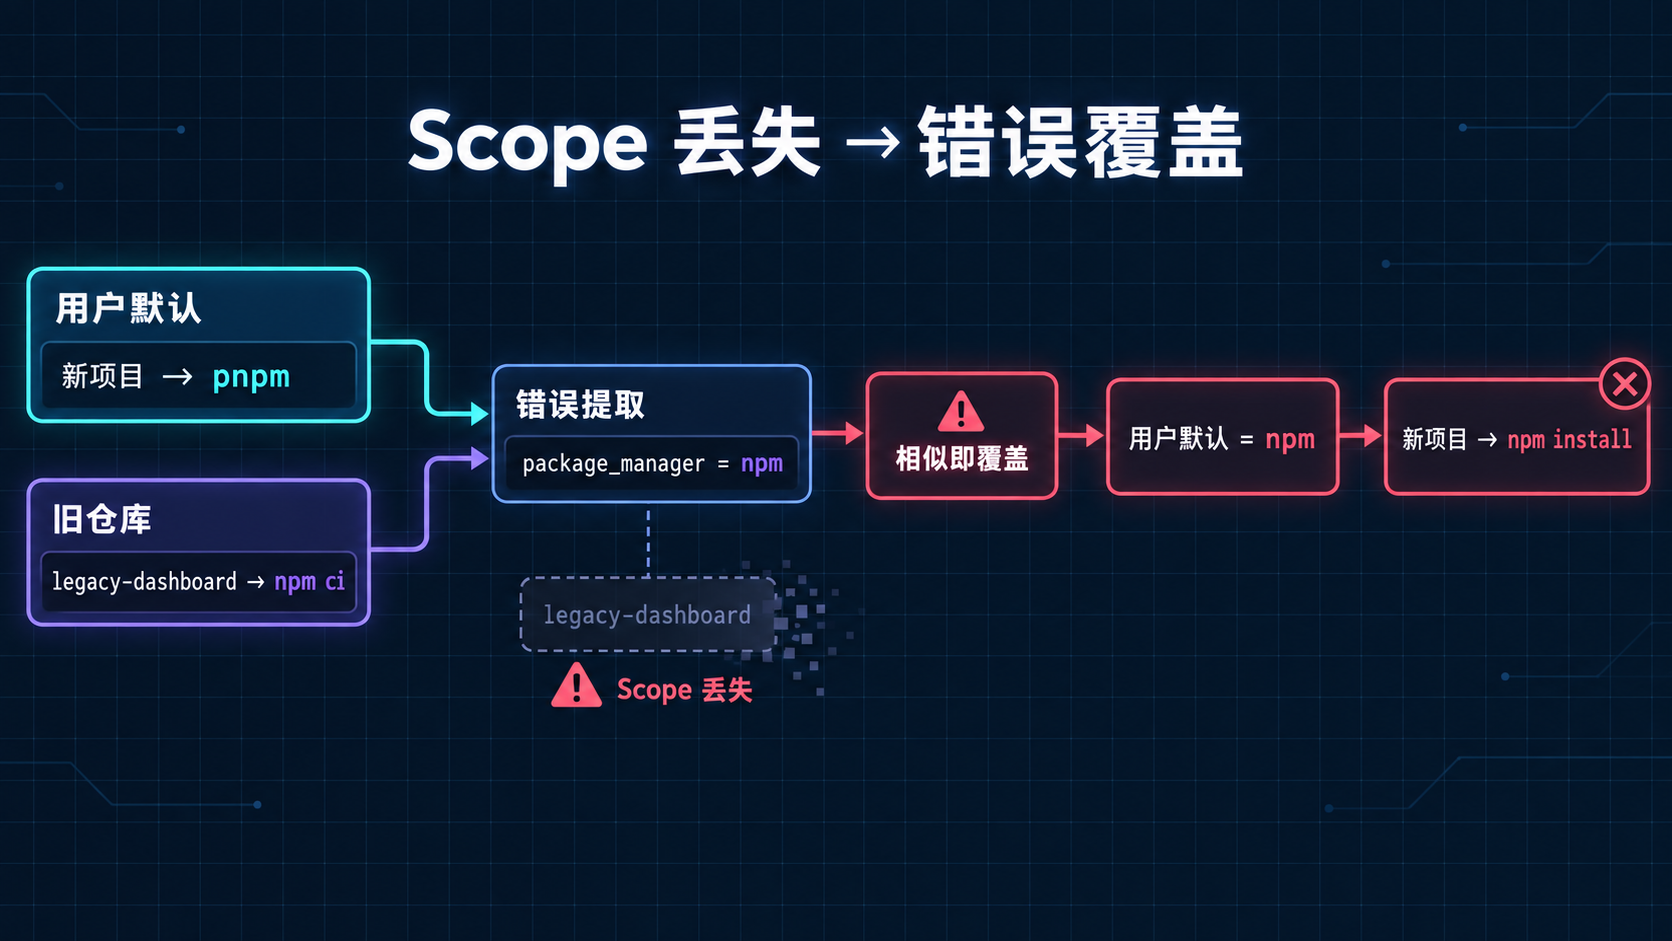
仓库信息没有进入结果。检索随后找到旧记录 package_manager = pnpm,更新逻辑看到两个 Predicate 一样,便把 pnpm 改成 npm。
到这里,信息已经丢了两次:第一次丢掉作用域,第二次抹掉旧值及其来源。后面换 PostgreSQL、向量数据库或更强的模型,都不会自动把这两部分补回来。存储层只是执行了应用定义的错误语义。
先确定「哪一条记忆」,再谈更新
对这类偏好,一条记录不能只靠 predicate 标识。至少还需要 Subject 和 Scope:
[
  {
    "subject": "user:42",
    "predicate": "package_manager",
    "value": "pnpm",
    "scope": {
      "type": "user_default"
    },
    "source": "thread:17/message:86",
    "status": "current"
  },
  {
    "subject": "user:42",
    "predicate": "package_manager",
    "value": "npm",
    "scope": {
      "type": "repository",
      "id": "legacy-dashboard"
    },
    "source": "thread:23/message:14",
    "status": "current"
  }
]
现在,两条记录的 Predicate 相同,身份却不同:
(user:42, package_manager, user_default)
(user:42, package_manager, repository:legacy-dashboard)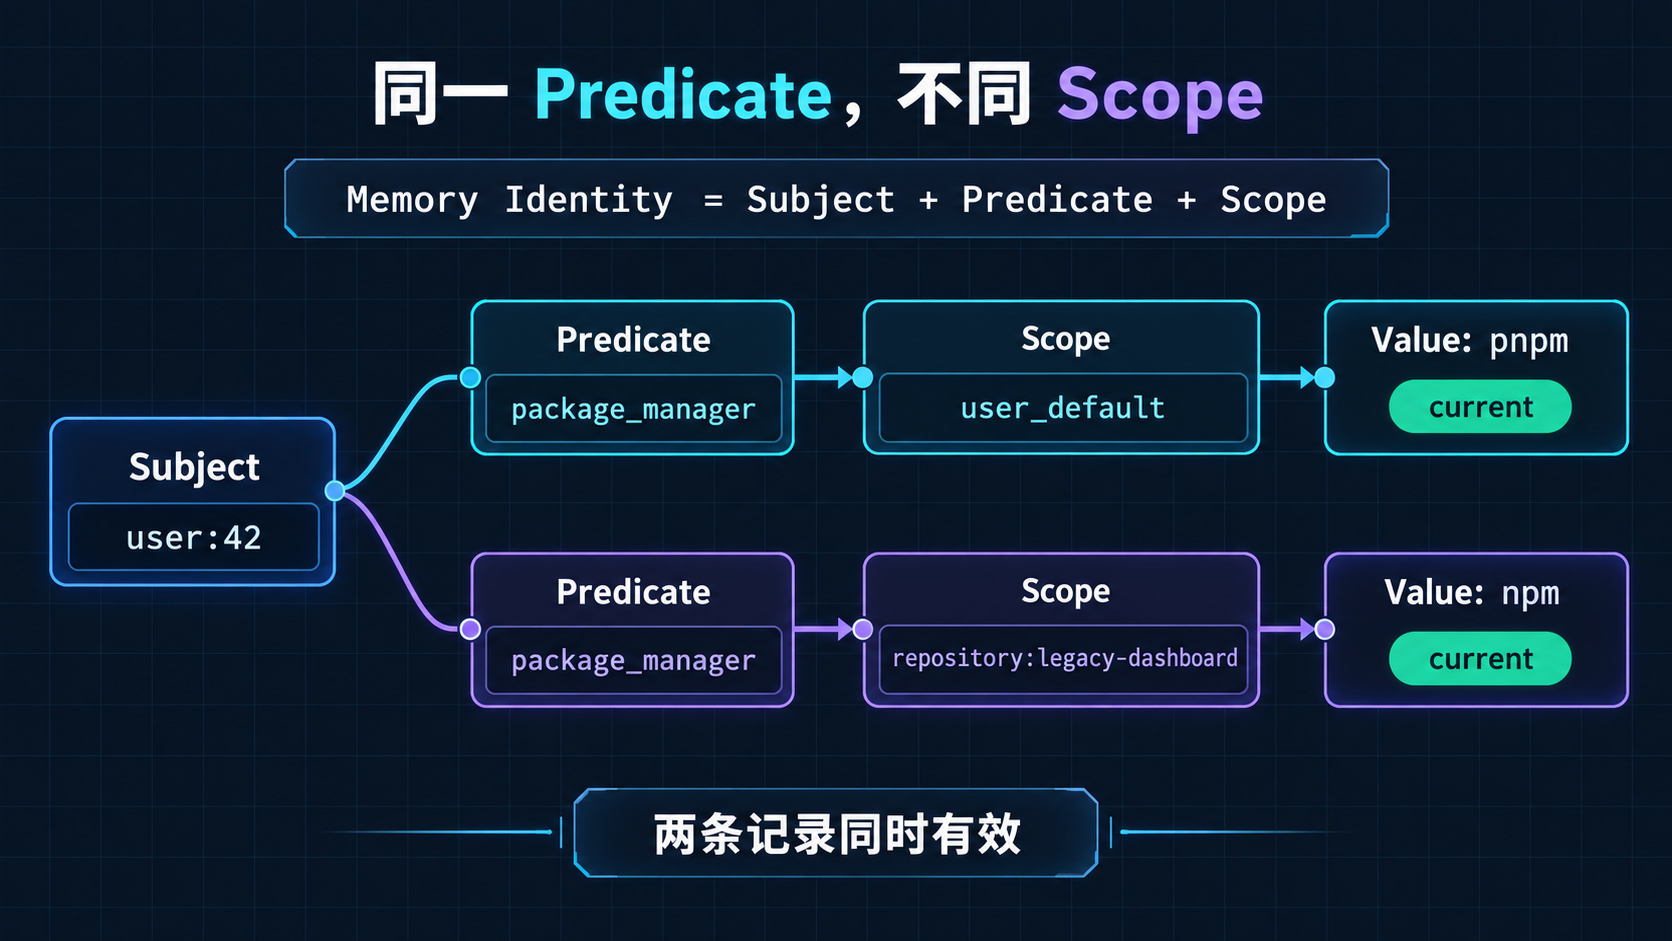
它们不需要互相覆盖。只有 Subject、Predicate 和 Scope 都指向同一件事时,系统才应该进入更新判断。
这也说明问题不在「传统数据库能不能理解自然语言」。数据库当然可以保存版本和作用域。难的是应用必须先把自然语言整理成稳定的身份,再决定执行 INSERT 还是 UPDATE。
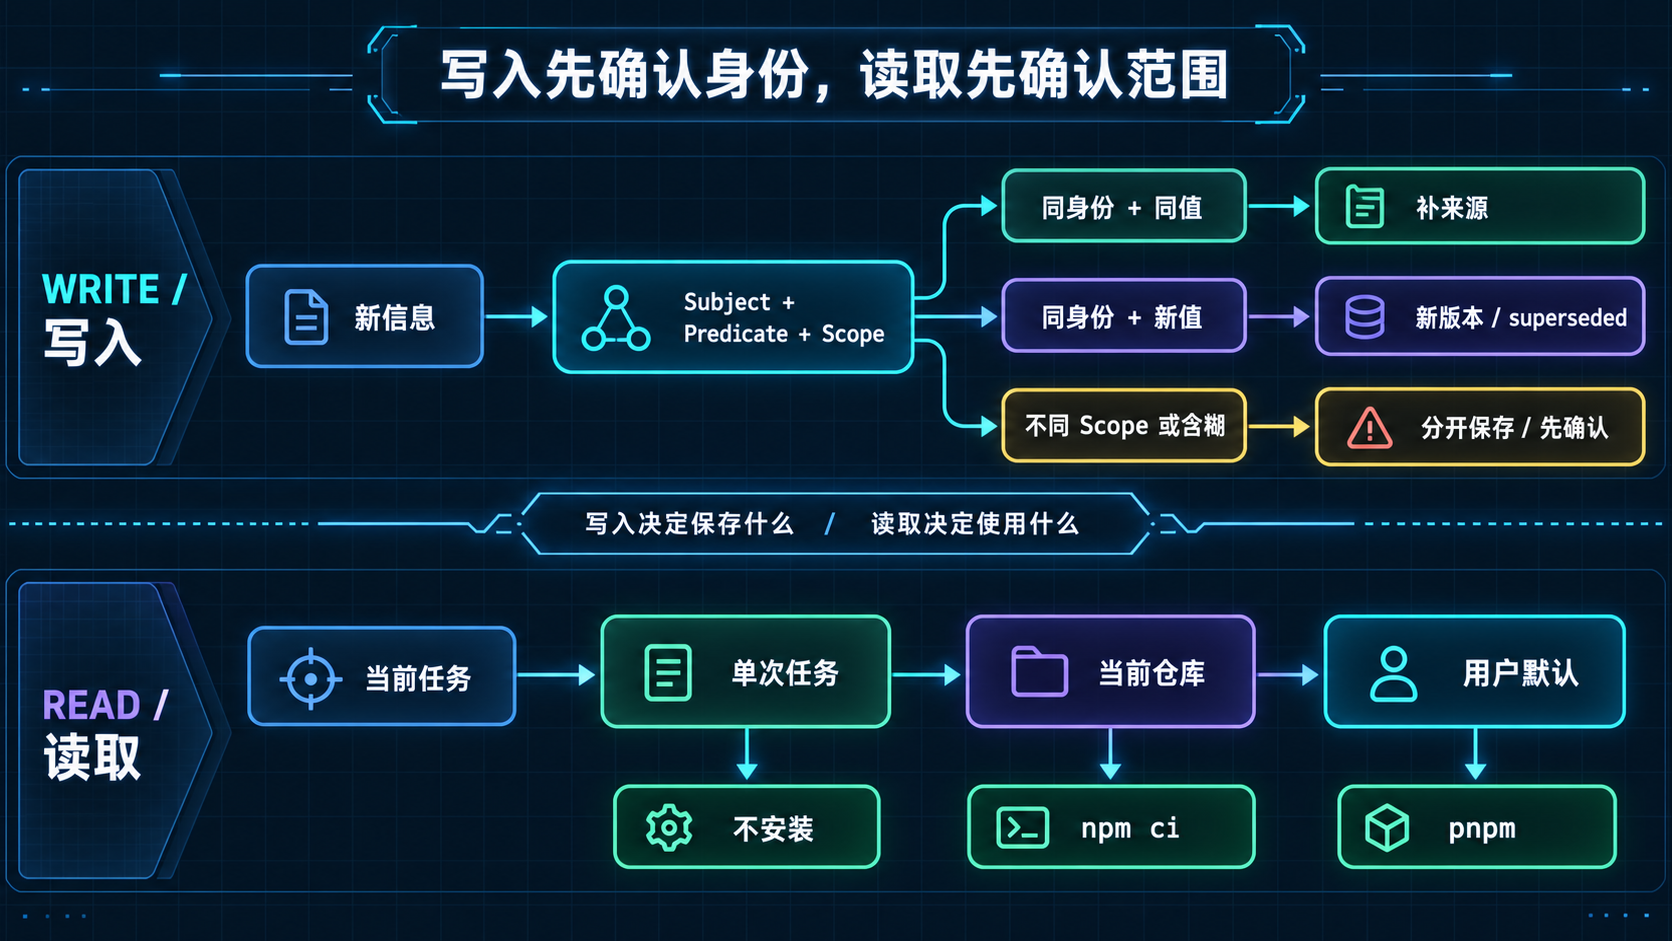
写入逻辑只需要先分清三种情况
不必一上来设计十几个 Memory Action。先把最容易出错的三种情况处理清楚:
| 判断结果 | 写入动作 |
|---|---|
| 同一身份,同一值 | 不新增;补充来源或最近确认时间 |
| 同一身份,新值明确取代旧值 | 写入新版本,把旧版本标为 superseded |
| Scope 不同,或关系仍然含糊 | 分开保存;无法确定时先不覆盖 |
写入顺序也要调整:
- 保留用户原话和消息 ID;
- 从 Runtime 获取当前用户、仓库和任务信息;
- 提取 Predicate、Value 与可能的有效时间;
- 用 Subject + Predicate + Scope 做精确查找;
- 只对同一身份判断是否取代,最后再写入。
能从 Runtime 确定的值,不要让 LLM 猜。当前仓库 ID、用户 ID、Thread ID 都应该来自运行环境。LLM 更适合帮助理解「以后都用 npm」是在修改全局偏好,还是仍然只针对眼前仓库;如果句子本身说不清,就向用户确认。
向量检索仍然有用,但位置要往后放。它可以从非结构化记录中找候选,不能代替身份判断。比如「喜欢简洁的代码」和「喜欢简洁的回复」可能很相似,前者属于代码风格,后者属于沟通偏好。距离再近,也不是同一条记录。
LongMemEval 把 Knowledge Update 单独列为长期记忆的一项能力。Supersede 预印本进一步研究了旧事实失效后,Agent 能否持续使用当前值。这也是为什么 Memory Update 不能只当成一次普通的语义检索。
读取时,不要让「最新」抢在「适用」前面
写入正确,只解决了一半。读取如果直接按更新时间倒序,仓库规则仍可能跑到全局偏好前面。
对这个例子,可以明确一条简单的优先级:
单次任务 > 当前仓库 > 用户默认它不是所有 Agent 都适用的行业标准,只是这个应用对包管理器偏好的读取策略。代码甚至不需要很复杂:
def resolve_package_manager(user_id, repository_id, task):
    if task.install_dependencies is False:
        return None

    repository_rule = memory.get(
        subject=user_id,
        predicate="package_manager",
        scope=("repository", repository_id),
    )
    if repository_rule:
        return repository_rule

    return memory.get(
        subject=user_id,
        predicate="package_manager",
        scope=("user_default", None),
    )
于是三个场景会得到不同结果:
- 新建项目,没有仓库规则,使用 pnpm;
- 打开
legacy-dashboard,命中仓库规则,执行npm ci; - 当前任务只检查 lockfile,不执行任何安装命令。
这一步最好由应用代码完成,而不是把三个互相竞争的规则全部塞进 Prompt,再让模型临场决定。Context Builder 最终只需要交给模型当前适用的规则,同时保留来源,方便解释和排查。
保留历史,不等于每次都把历史交给模型
真正发生全局偏好变化时,例如用户明确说「以后新项目也改用 npm」,旧的 pnpm 记录就应该失效。但失效不等于立即抹掉。
一个够用的实现可以分成两份数据:
- Current View 保存当前有效值,负责日常查询;
- History Log 记录旧值、新值、来源和更新时间,负责追溯。
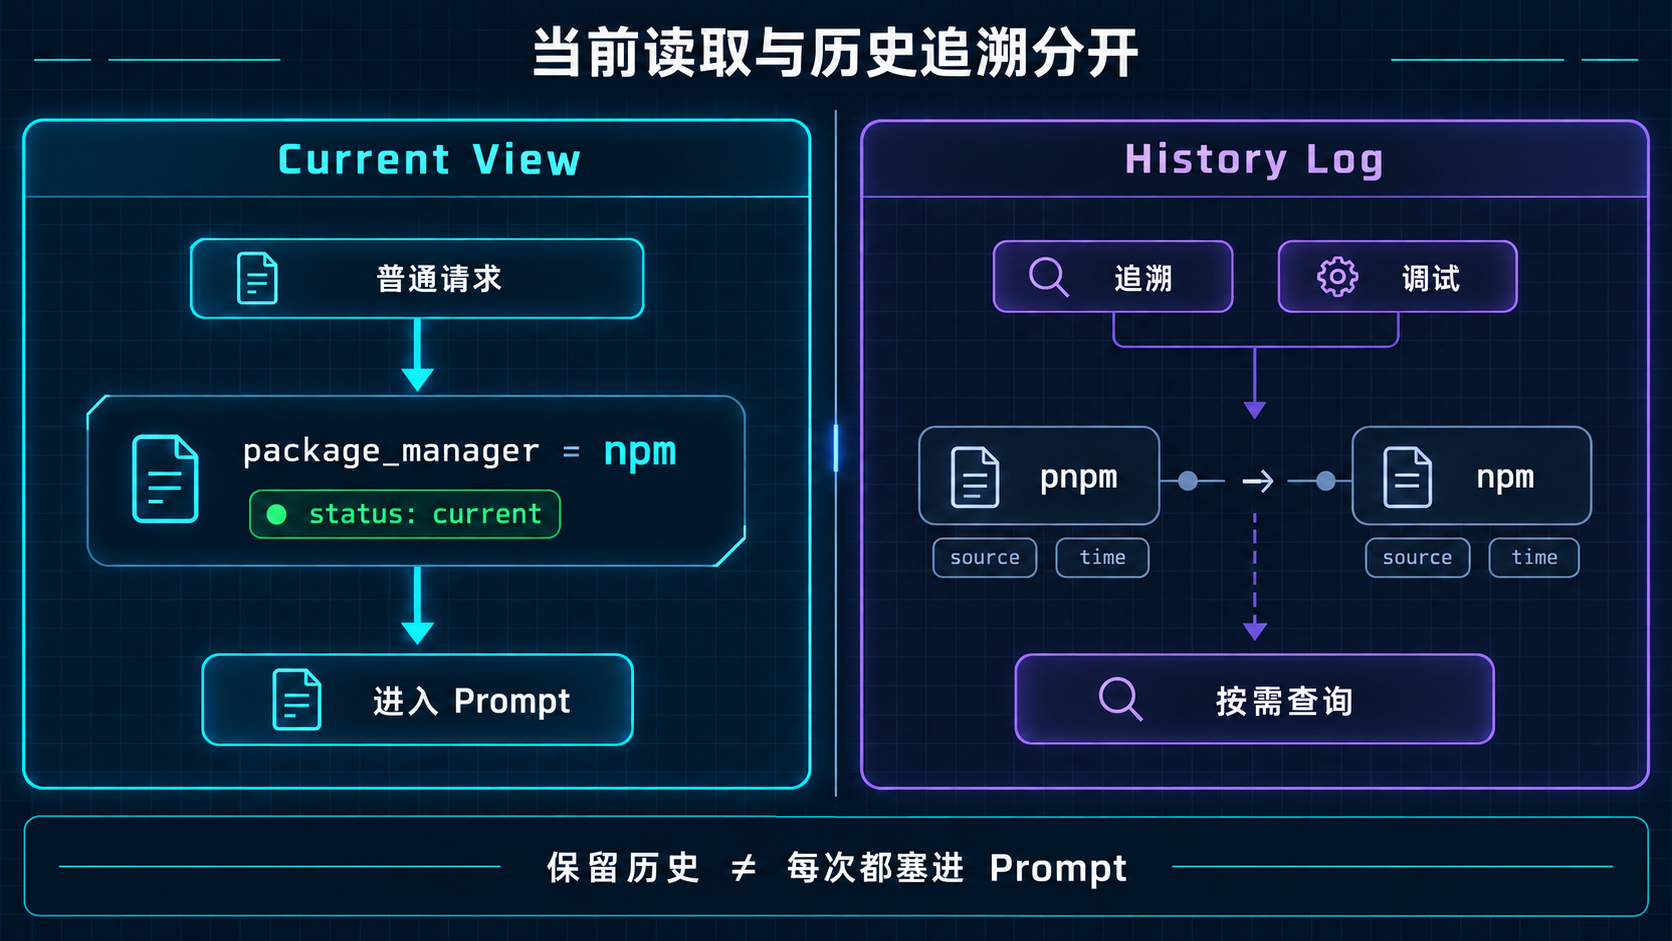
正常请求只读取 Current View。只有用户问「以前用什么」、系统需要解释一次变化,或者你正在调查错误时,才查询 History Log。这样既不需要让模型每次阅读所有版本,也不会因为一次覆盖而失去排错线索。
History Log 也不是绕过删除请求的借口。用户要求删除的数据,或已经超过保留期的敏感内容,仍要从持久层删除或做不可逆匿名化;日志最多留下不含原始内容的删除事件。
摘要丢失是另一个问题
原文把对话摘要丢失也归入「记忆覆盖」。两者都会让 Agent 忘事,但发生位置不同。
当前 LangChain 文档中的 SummarizationMiddleware 会用摘要替换较早的消息,目的是控制 Context 长度。摘要可能漏掉版本号、否定词或约束,所以关键事实不应只存在摘要里。它们应该进入结构化 State 或 Long-Term Memory,并保留原始来源。
这属于 Context 管理中的有损压缩,不是两条长期记忆之间的更新冲突。分开排查,才知道应该修摘要策略,还是修 Memory 的身份和作用域。
框架提供存储,更新语义仍然归应用
LangGraph 的长期存储使用 namespace + key 组织 JSON 文档,并支持过滤和语义搜索。它能提供实现所需的基础能力,但 Profile 怎么更新、仓库级规则如何覆盖全局规则,仍然要由应用定义。
Mem0 更能说明为什么要核对版本。当前开源 Python 实现中,add(..., infer=True) 可以让 LLM 判断新增、更新或删除;Mem0 在 2026 年 4 月公布的新托管算法却采用 ADD-only 提取,明确不做 UPDATE/DELETE。两者都叫 Mem0,写入行为并不相同。
框架能省掉存储和检索的样板代码,省不掉业务里的那句判断:这条新信息,究竟在修改谁、修改哪个范围里的什么?
上线前,用这五个场景检查更新逻辑
| 操作 | 预期结果 |
|---|---|
| 再次说「新项目默认用 pnpm」 | 不产生重复记录,只更新确认时间或来源 |
在 legacy-dashboard 中说「这里用 npm ci」 |
新增仓库规则,不修改用户默认值 |
| 明确说「以后新项目改用 npm」 | 用户默认值更新,旧值可追溯但不再参与当前读取 |
| 只说「以后都用 npm」但上下文无法确定范围 | 不静默覆盖,先确认是全局还是当前仓库 |
| 要求删除包管理器偏好 | Current View 与包含原始内容的历史记录都按删除策略处理 |
长期记忆的验证不能只看「搜没搜到」。还要看系统有没有取到正确用户、正确仓库、正确时间下仍然有效的那一条。
修完之后,pnpm 和 npm 会作为两条不同作用域的记录同时存在。创建新项目时用 pnpm,进入旧仓库时执行 npm ci。这里没有更复杂的 Prompt,也不需要模型突然变聪明。
真正改变的是,系统不再把「刚刚说过」误认为「在所有地方都生效」。
参考资料
- LangChain, Memory overview:Thread-Scoped State、Long-Term Memory、Profile、Collection 与写入时机的当前定义。
- LangChain, Short-term memory:当前消息裁剪、删除和
SummarizationMiddleware的使用方式。 - Wu et al., LongMemEval:将 Knowledge Update、Temporal Reasoning 等列为长期交互记忆的独立能力。
- Patel, Supersede:研究旧事实失效后的 supersession gap;截至本文写作时为预印本。
- Mem0 开源仓库 与
Memory.add当前实现:用于核对不同版本的写入语义。 - 原始参考文章:本次改造的知识线索来源。