· ARJUN · WRITING
在构建一个复杂的 Agent 时,会遇到哪些挑战?
一个复杂 Agent 往往要连续规划、调用工具、处理失败并验证结果。只要其中一环缺少边界,任务即使跑完也可能无法交付。本文从一次跑偏的 CI 排障开始,拆解开发中最常见的五类挑战。
你给编程 Agent 一个任务:
找出昨晚 CI 失败的原因,完成修复并创建 Pull Request。不要修改部署配置。
它先读取失败日志,再检索代码,修改测试超时时间,重新运行测试,最后创建 PR。每一次工具调用都返回成功,PR 里也有一段完整的原因说明。
看上去,任务做完了。
但日志接口默认只返回最后 500 行。Agent 看到的是结尾的 test timed out after 60s,没有看到前面更早出现的连接池耗尽。它把超时从 60 秒改成 120 秒,本地重跑恰好通过,随后把「测试时间不足」写成了根因。
工具没有报错,执行链也没有中断,结果仍然不能交付。
这类问题很难靠一句更长的 Prompt 解决。模型、计划、工具、外部环境和停止条件共同组成了一条执行链。把这条链拆开,复杂 Agent 的工程难点主要集中在五处:怎样定义可靠,计划如何跟随环境调整,工具失败后怎样恢复,错误发生后如何复盘,以及怎样控制整条链的成本和延迟。
挑战一:一次跑通,离可靠还很远
先从最容易被忽略的地方说起:到底怎样才算完成?
「修复 CI」对人来说像一个明确目标,对 Runtime 来说却缺少很多东西:什么算根因,哪些文件不能改,哪组测试可以证明修复有效,什么情况必须停下来问人。
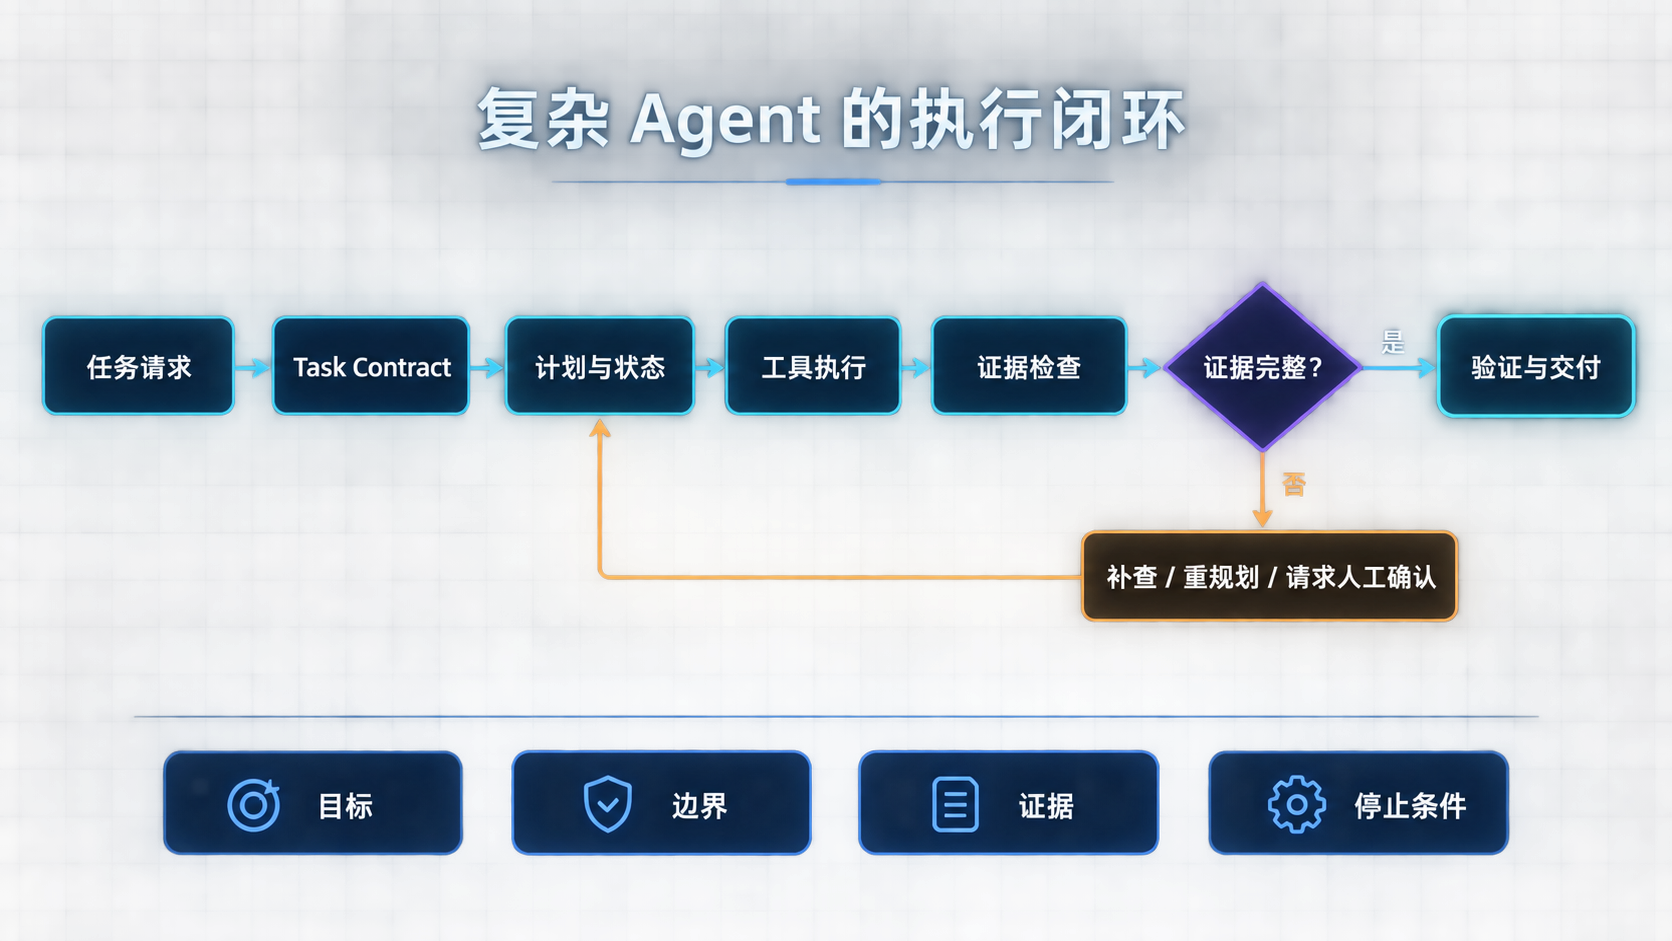
如果这些内容只藏在自然语言里,Agent 很容易把「成功创建 PR」当成「成功修复问题」。更稳妥的做法,是在执行前把任务整理成一个可检查的 Task Contract:
goal: 找到 CI 失败的根因并提交最小修复
constraints:
  - 不修改部署配置
  - 不写入生产环境
evidence_required:
  - 覆盖完整失败时间窗口的日志
  - 能复现原始失败
  - 相关回归测试通过
deliverable:
  - 包含根因、改动和验证证据的 Pull Request
stop_when:
  - 日志不完整
  - 需要超出权限的操作
  - 证据之间互相冲突
这不是为了把自然语言全部变成配置文件,而是把最容易在多步执行里丢掉的内容固定下来:交付物、边界、证据和停止条件。
模型可以决定下一步怎么走,但不能在执行到一半时悄悄改掉「什么算完成」。
同一个任务要经得住重复运行
同一个任务重复运行,可能得到不同的工具选择和执行路径。原因不只来自模型采样:检索结果会变化,外部 API 会超时,上下文可能被裁剪,仓库状态也可能已经更新。
τ-bench 把 Agent 放进带有用户、工具和业务规则的任务中,不只检查最终回答,而是比较任务结束后的数据库状态。它还用重复运行衡量同一个任务能否持续成功。这个设计说明了一个容易被单次 Demo 掩盖的问题:跑通一次只能证明这次成功,不能证明下一次仍会遵守同样的规则。
工程上不必追求每条自然语言轨迹完全一致。需要稳定的是这些结果:
- 最终状态满足验收条件;
- 权限与业务约束没有被绕过;
- 每个关键判断都有可追溯证据;
- 出现未知状态时不会继续扩大影响。
稳定的结果,可以建立在不同的执行路径上。
挑战二:计划会被真实环境打断
复杂任务通常需要规划,但「先列五个步骤,然后照着做」仍然太脆弱。日志查不到、测试无法复现、工具权限不足,都会让原计划失效。
ReAct 的核心思路是交错进行推理与行动:执行一个动作,读取环境返回的 Observation,再决定下一步。Plan-and-Execute 则先形成较完整的计划,再由执行器逐步完成,并在必要时重新规划。它们解决的是不同粒度的控制问题,没有一种模式适合所有任务。
无论采用哪种方式,计划最好进入可持久化 State,而不是只留在模型生成的一段文字里:
{
  "step": "collect-ci-evidence",
  "status": "blocked",
  "depends_on": ["locate-failed-job"],
  "evidence": ["job:9182/log-page:1"],
  "missing": ["earlier_log_pages"],
  "retry_budget": 1,
  "next": "request-next-log-cursor"
}
这样 Runtime 才能回答几个关键问题:当前卡在哪一步,依据是什么,还缺什么,是否允许重试,以及恢复后从哪里继续。
上一篇关于 Agent Planning 的文章讨论了不同规划方法。这一篇更关心计划落到生产系统后怎样被保存、验证和修订。
挑战三:工具成功了,任务仍可能失败
日志接口返回 200,证据仍可能少一半。
工具调用至少有四层不同的「成功」:
- Transport: 请求发出并收到响应;
- Schema: 字段和类型符合接口定义;
- Semantic: 结果完整、时效正确,并能回答当前问题;
- Effect: 有副作用的操作只发生了一次,而且发生在允许的对象上。
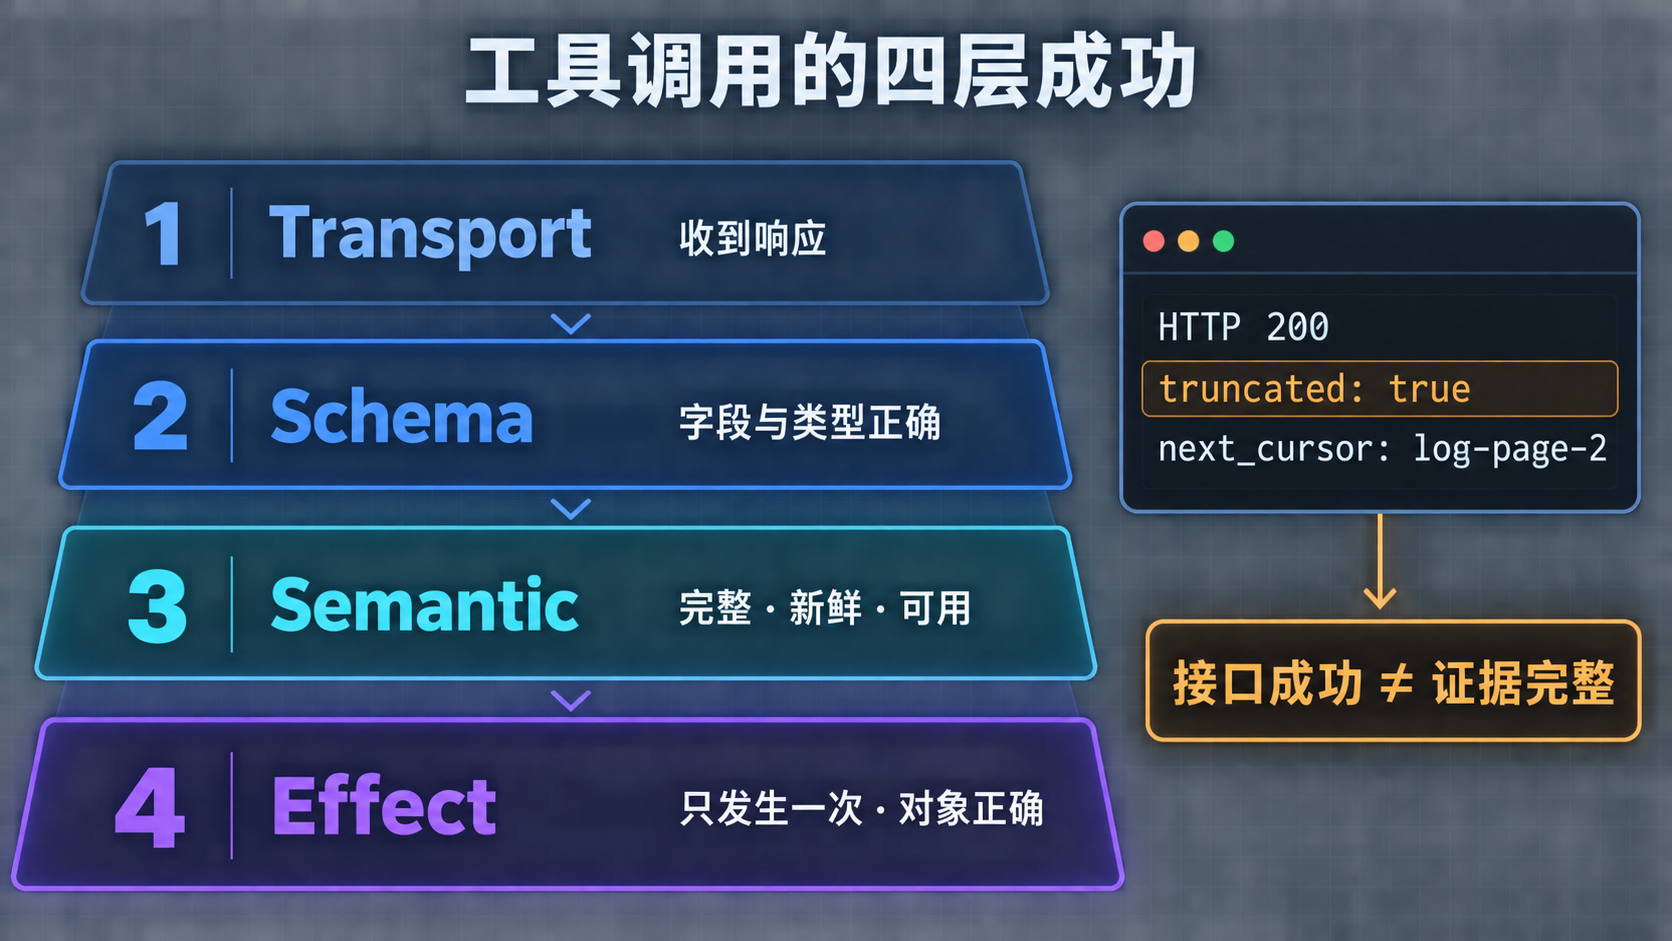
开头的日志接口只满足了前两层。更有用的返回结构应该把完整性也暴露出来:
{
  "status": "ok",
  "lines": ["..."],
  "window": {
    "from": "2026-09-16T23:48:10Z",
    "to": "2026-09-16T23:52:31Z"
  },
  "truncated": true,
  "next_cursor": "log-page-2"
}
Schema 校验能阻止 next_cursor 被写成一个对象,却不能替 Agent 判断「这 500 行是否足以定位根因」。工具契约还需要说明数据范围、来源、更新时间、是否截断,以及这次调用产生了什么副作用。
工具描述也不该只写「查询日志」。它应该告诉模型什么时候使用、不能用来证明什么、可能返回哪些不完整状态,以及遇到这些状态后应该怎么处理。
写操作超时以后,先别急着重试
外部工具失败后,最容易写出的策略是「最多重试三次」。它对部分读取请求有效,对写操作却可能制造新问题。
假设 Agent 调用 Git 平台创建 PR,客户端等待超时。此时有两种可能:服务器没有收到请求,或者 PR 已经创建,只是响应没有返回。直接重试可能产生重复 PR。
更稳妥的顺序是:
发送创建请求
  → 响应超时,结果未知
  → 按分支名或操作标识查询现有 PR
  → 已存在:记录结果并继续
  → 不存在:确认请求可安全重放后再重试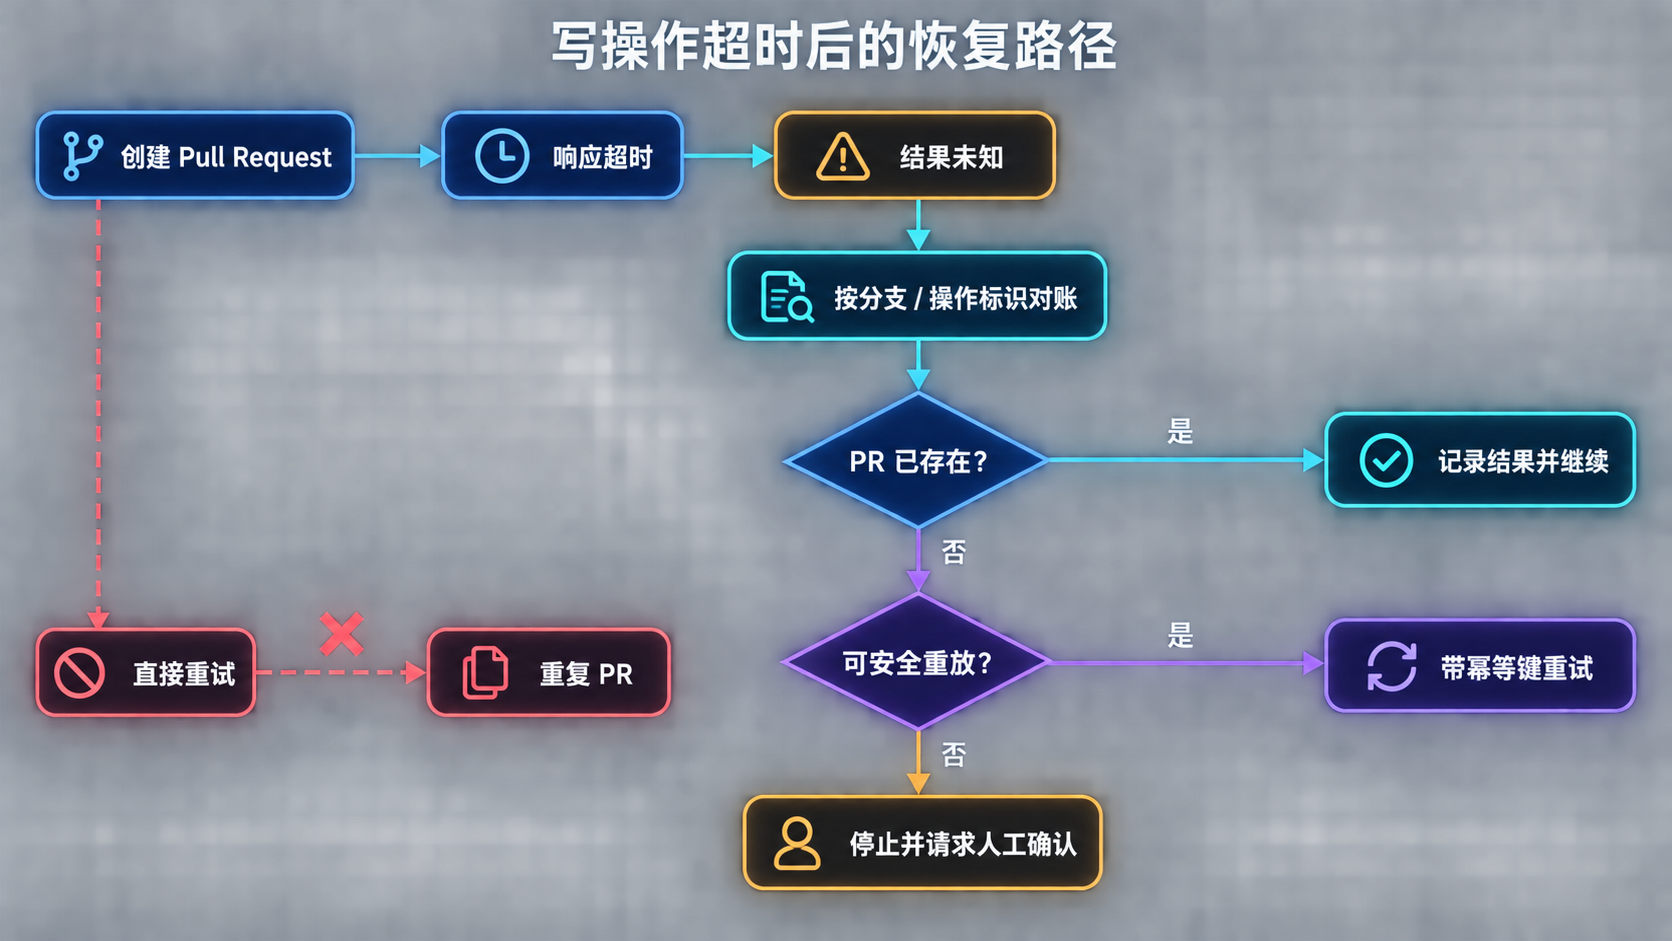
不同错误需要不同策略:
| 失败类型 | 处理方式 |
|---|---|
| 临时网络错误、无副作用读取 | 有上限的重试与退避 |
| 参数不符合 Schema | 修复参数后重新调用 |
| 权限不足或认证失败 | 停止,不用重复请求掩盖问题 |
| 写操作超时、结果未知 | 先 Reconcile 当前状态,再决定是否重放 |
| 返回成功但证据不完整 | 补充查询或标记 Blocked,不进入下一阶段 |
Idempotency Key 能帮助服务识别重复操作,但前提是服务端实现了对应语义。没有这个能力时,Runtime 至少要保存操作标识、调用前状态和可用于对账的业务键。
失败恢复往往比第一次调用成功更难,因为系统必须知道:什么已经发生,什么只是准备发生,什么仍然无法确认。
挑战四:错误发生后,必须能复盘和评估
Trace 要留下能复盘的现场。
普通应用日志经常只留下「请求开始」「请求结束」和错误堆栈。对 Agent 来说,这不足以解释为什么它从查日志走到了修改超时。
一条可用的 Trace 至少应该串起:
- 任务版本、模型版本和 Prompt 版本;
- 当前 State 与计划步骤;
- 工具名称、参数、返回范围和错误;
- 每一步耗时、Token 与重试次数;
- 触发重规划、停止或人工确认的原因;
- 最终交付物及其验证证据。
LangSmith 和 Langfuse 都能记录模型调用、工具步骤、延迟和 Token 等信息。它们解决的是采集与查看问题,不会自动告诉你哪条业务规则写错了。字段怎么设计、敏感数据怎样脱敏、哪些证据需要长期保留,仍然属于应用架构。
无需把模型隐藏的 Chain of Thought 全部保存下来。调试所需的是应用能够观察的输入、输出、状态转换和外部动作。把这些信息串起来,已经足以定位大部分「从哪一步开始偏了」。
评估不只给最终回答打分
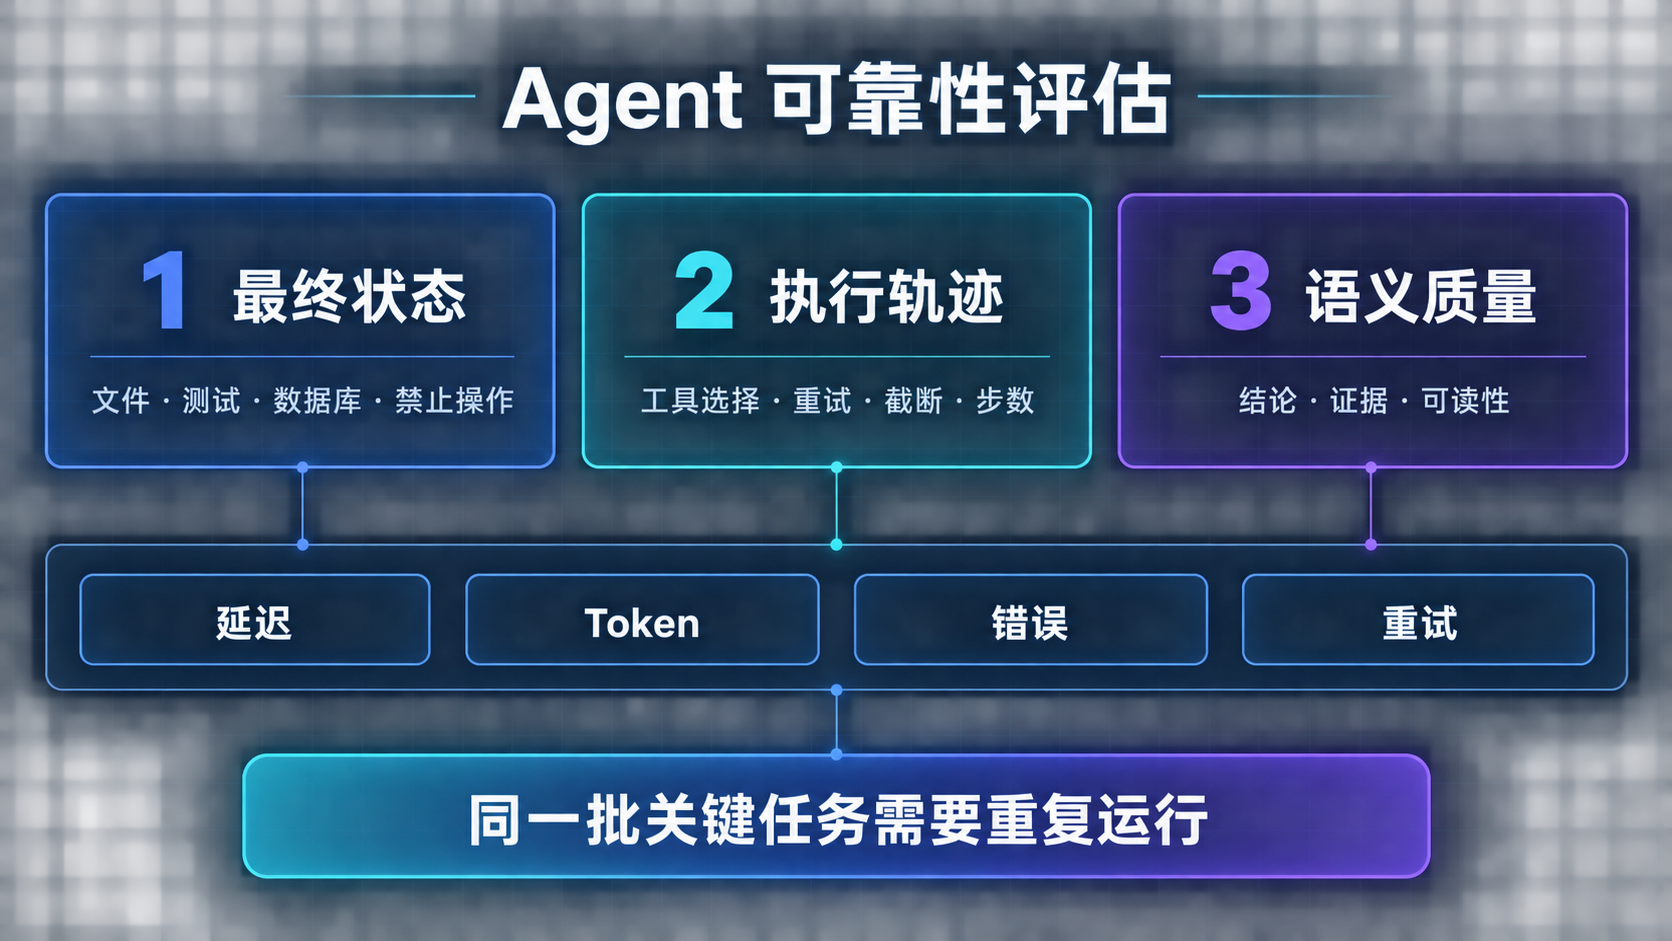
如果评估只问「最终回答读起来怎么样」,一个错误诊断也可能因为表达完整而得到高分。Agent 的评估至少需要三层:
1. 最终状态
用确定性检查回答:目标文件是否按预期修改,测试是否通过,数据库是否达到目标状态,禁止操作是否从未发生。
2. 执行轨迹
检查 Agent 是否选错工具、重复调用、忽略截断标记、超出步数预算,或者在证据不足时继续执行高影响动作。
3. 语义质量
判断根因说明是否准确、引用证据是否支持结论、PR 描述是否足够让审阅者理解。这里可以使用带 Rubric 的 LLM-as-a-Judge,但它不该单独充当事实裁判。确定性结果、人工标注样本和定期抽查仍然必要。
评估集也不能只放正常路径。至少要覆盖:工具超时、空结果、截断结果、权限不足、Schema 变化、重复写入和互相冲突的证据。
还要把同一批关键任务重复运行。单次成功率告诉你 Agent 有没有能力完成,重复成功则更接近用户真正感受到的可靠性。
挑战五:每一步都在消耗时间和预算
每增加一次模型调用、检索或工具往返,都会增加成本和等待时间。更复杂的 Agent 有时能完成更开放的任务;如果只是多绕几轮再得到同一个结果,那些步骤只是在消耗预算。
Anthropic 在 Building effective agents 中建议从最简单的方案开始:路径稳定、规则明确的任务更适合由代码编排的 Workflow;只有当步骤无法提前写死、确实需要模型根据环境决定下一步时,才增加 Agent 自主性。
常见优化需要带着边界使用:
- 简单请求直接路由到较短的 Workflow,不进入完整 Agent Loop;
- 相互独立的读取可以并行,有依赖或副作用的操作保持顺序;
- 只缓存输入和权限边界稳定的结果,避免复用已经过期的外部状态;
- 给每次任务设置步数、时间和成本预算,超出后返回当前证据;
- Streaming 可以更早显示进度,但不会自动缩短后台完成全部步骤的时间。
优化的目标不是让 Agent 少想几步,而是让每一步都值得。
上线前检查表
| 检查项 | 要回答的问题 |
|---|---|
| 完成条件 | 什么最终状态才算交付,而不只是流程结束? |
| 权限边界 | 哪些动作可自动执行,哪些必须确认,哪些禁止? |
| 工具契约 | 返回值是否暴露来源、时间范围、截断和副作用? |
| 状态保存 | 中断后能否知道最后确认成功的是哪一步? |
| 失败恢复 | 读失败、写超时和权限错误是否使用不同策略? |
| 执行预算 | 是否限制步数、时间、Token 和重复调用? |
| Trace | 能否从最终结果追到每条证据和状态转换? |
| 评估集 | 是否同时检查终点、轨迹、异常路径和重复运行? |
回到开头那次 CI 排障。一个可以交付的 Agent,不只是创建了 PR。它还应该说清楚:哪段完整日志支持根因,哪项修改对应这个原因,哪些测试证明问题已经消失,以及它遵守了哪些不能触碰的边界。
如果这些都没有,剩下的只是一条执行成功的工具链,和一段听起来很像答案的总结。
创建了 PR 只是流程结束;找到真实原因并提供完整证据,任务才算真正完成。
参考资料
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models:交错生成推理轨迹与动作,并根据环境观察更新后续步骤。
- Yao et al., τ-bench:在真实领域规则、用户交互和工具调用中评估 Agent,并比较最终数据库状态与重复运行可靠性。
- Anthropic, Building effective agents:Workflow 与 Agent 的架构区别,以及复杂度、延迟和成本之间的取舍。
- Anthropic, Trustworthy agents in practice:工具权限、人工控制与高影响动作的边界。
- Google Cloud, Agent observability:Agent 的模型交互、工具调用、延迟、错误与质量观测。
- LangSmith Observability 与 Langfuse Observability:Agent Trace 的当前实现与数据范围。
- OpenAI, GDPval:自动评分器与领域专家评分之间的当前边界。
- 原始参考文章:本次改造的知识线索来源。