· ARJUN · WRITING
多 Agent 系统的收益,取决于任务怎么拆
一次代码评审可以交给一个 Agent 从头做到尾,也可以拆给几个 Agent 并行检查。后者什么时候值得做?关键要看任务能否独立完成,以及结果怎样交接。
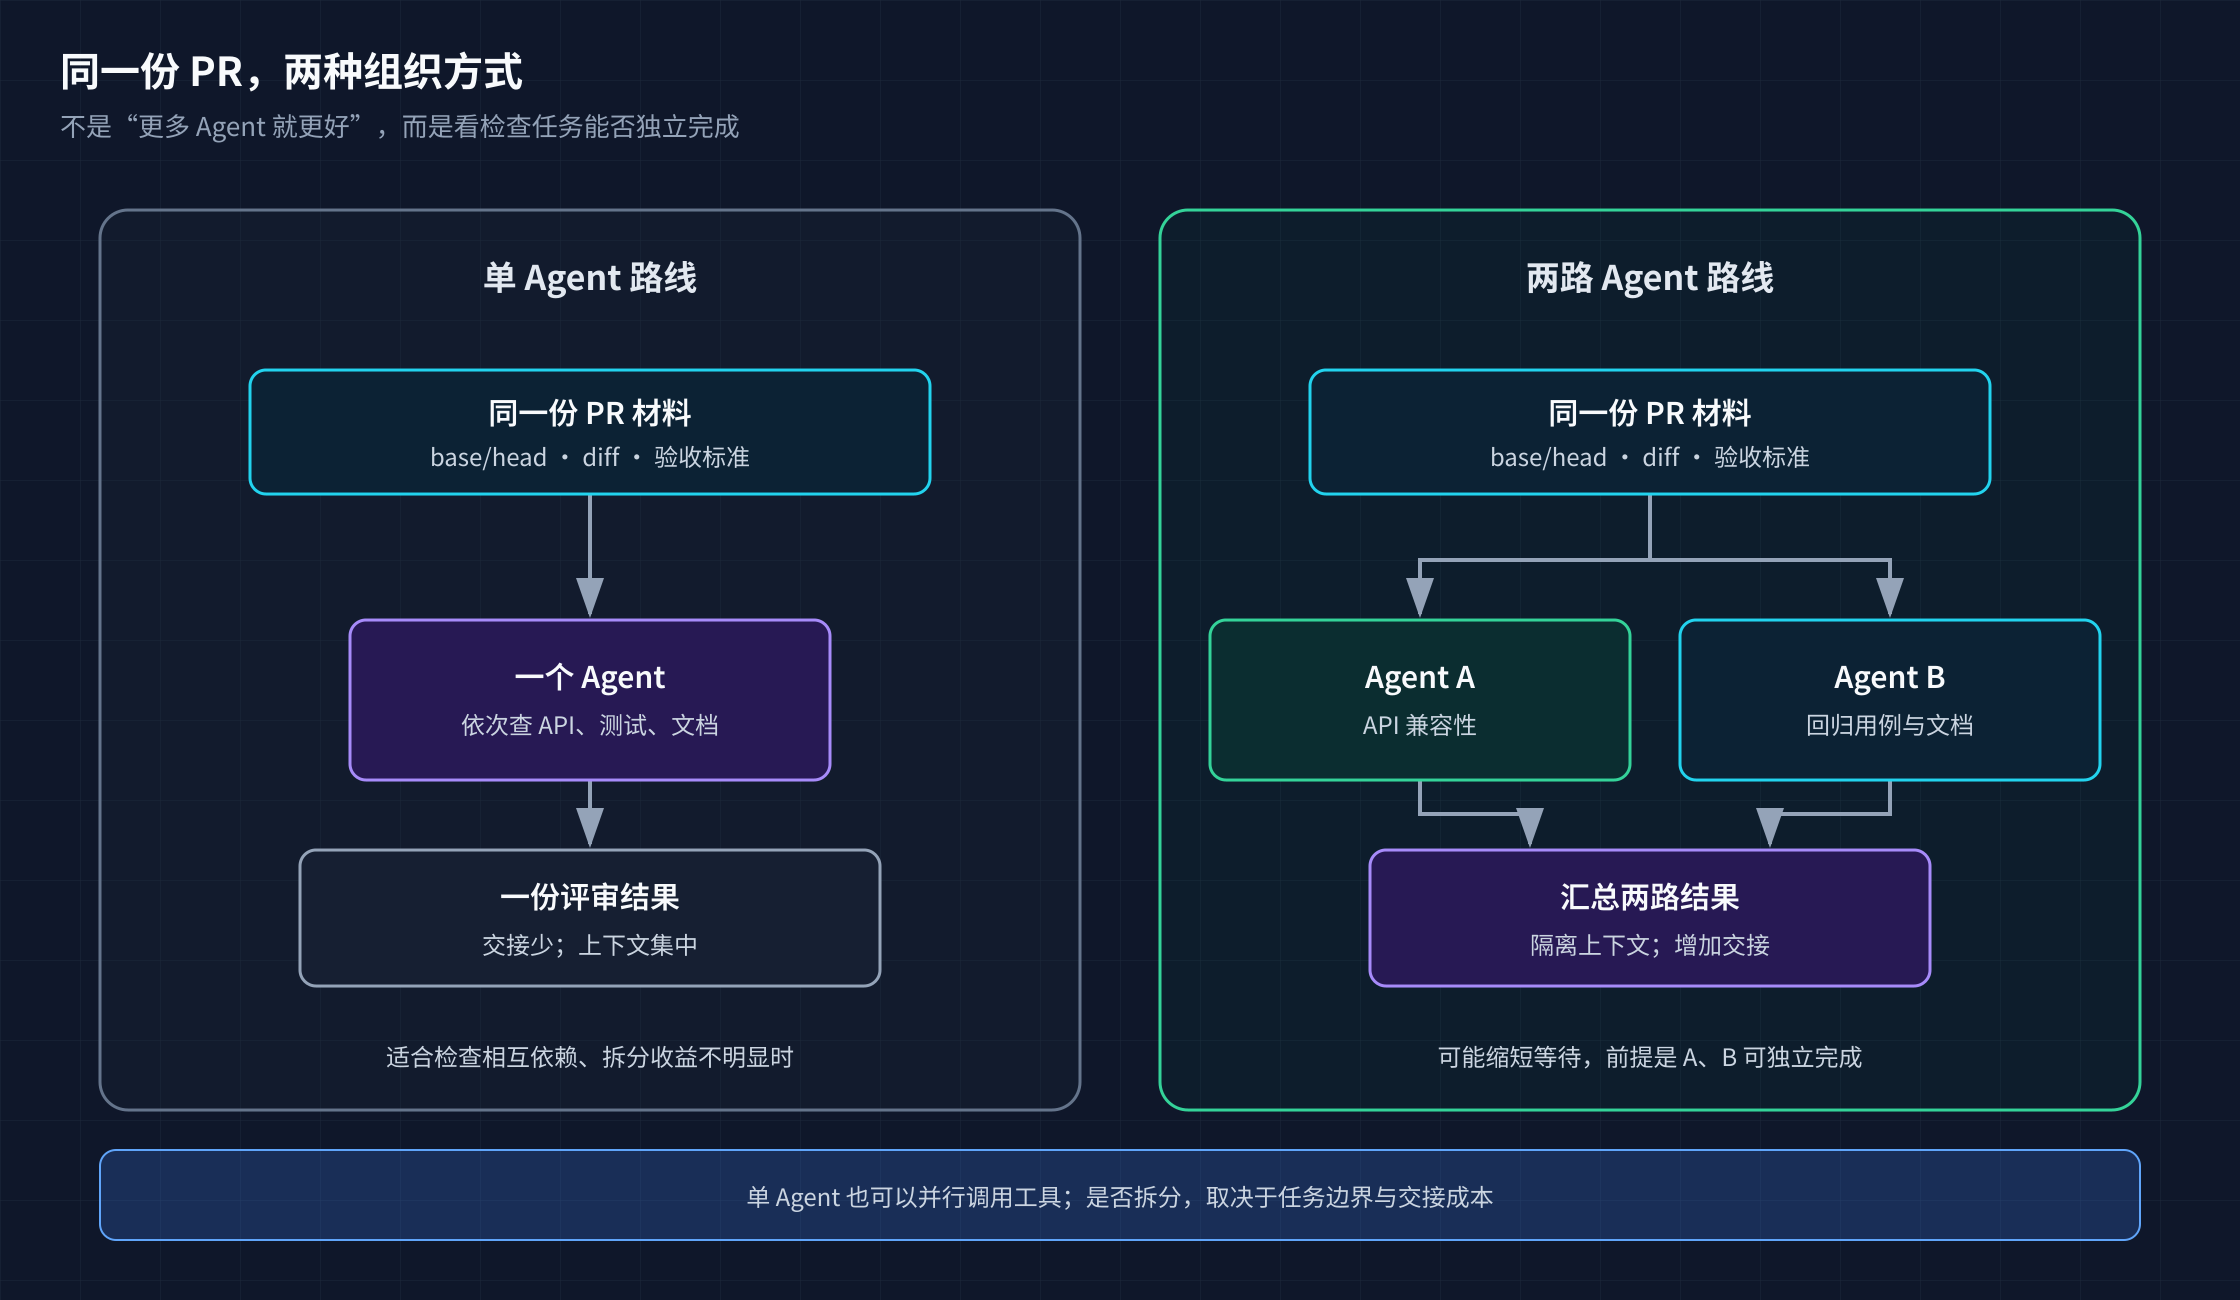
假设有一个改动范围很大的 Pull Request。合并前需要检查 API 是否保持兼容,还要看测试和文档有没有跟上。让一个 Agent 依次做完这些事当然可以;把两项检查分别交给两个 Agent,最后再汇总,也是一种选择。
区别不在于角色名字。多 Agent 系统真正改变的是:谁看哪些材料、谁做判断,以及各自的结果怎样汇总。拆分做得好,可以隔离上下文、并行处理;拆分做得不好,系统只会多出几次模型调用和一串难追踪的消息。
先看单 Agent 是否已经够用
一个 Agent 可以使用多种工具,也可以在编排允许时并行调用工具。因此,“需要并行”不等于“必须增加 Agent”。如果任务步骤固定,普通程序负责调度,Agent 只处理需要语言理解和判断的部分,通常更直接。
这里把 Agent 当作能围绕一项检查选择工具、读取材料并作出判断的执行单元。如果只是按预定顺序调用两次模型,再把回答拼起来,那仍然是一个固定工作流;多设两个角色名并不会改变任务边界。
考虑多 Agent,往往是因为单 Agent 开始承担几类差异很大的工作:工具太多,选错工具的情况增加;不同子任务需要很长且互不相关的上下文;或者几项检查彼此独立,可以同时运行。LangChain 的多 Agent 文档也把上下文管理、并行处理和能力边界列为主要动机,同时提醒复杂任务不一定需要多个 Agent。
这只是架构上的机会,不是质量保证。把“代码审查员”和“文档审查员”写进两段 System Prompt,不会自动让审查更准确。输入材料、工具和验收标准仍然决定结果。
用一次 PR 评审画清交接边界
先确定比较对象。PR 的 base 与 head commit SHA 能锁定代码差异,但判断对外兼容性时,还要说明比较基线是否对应已发布版本,并提供 API 契约、兼容规则和已知调用方。否则,A 即使看完 diff,也未必知道某处改动算不算破坏性变更。B 则需要验收标准和改动涉及的文档、回归用例;这里检查的是相关用例有没有跟上,不是追求一个笼统的测试覆盖率数字。
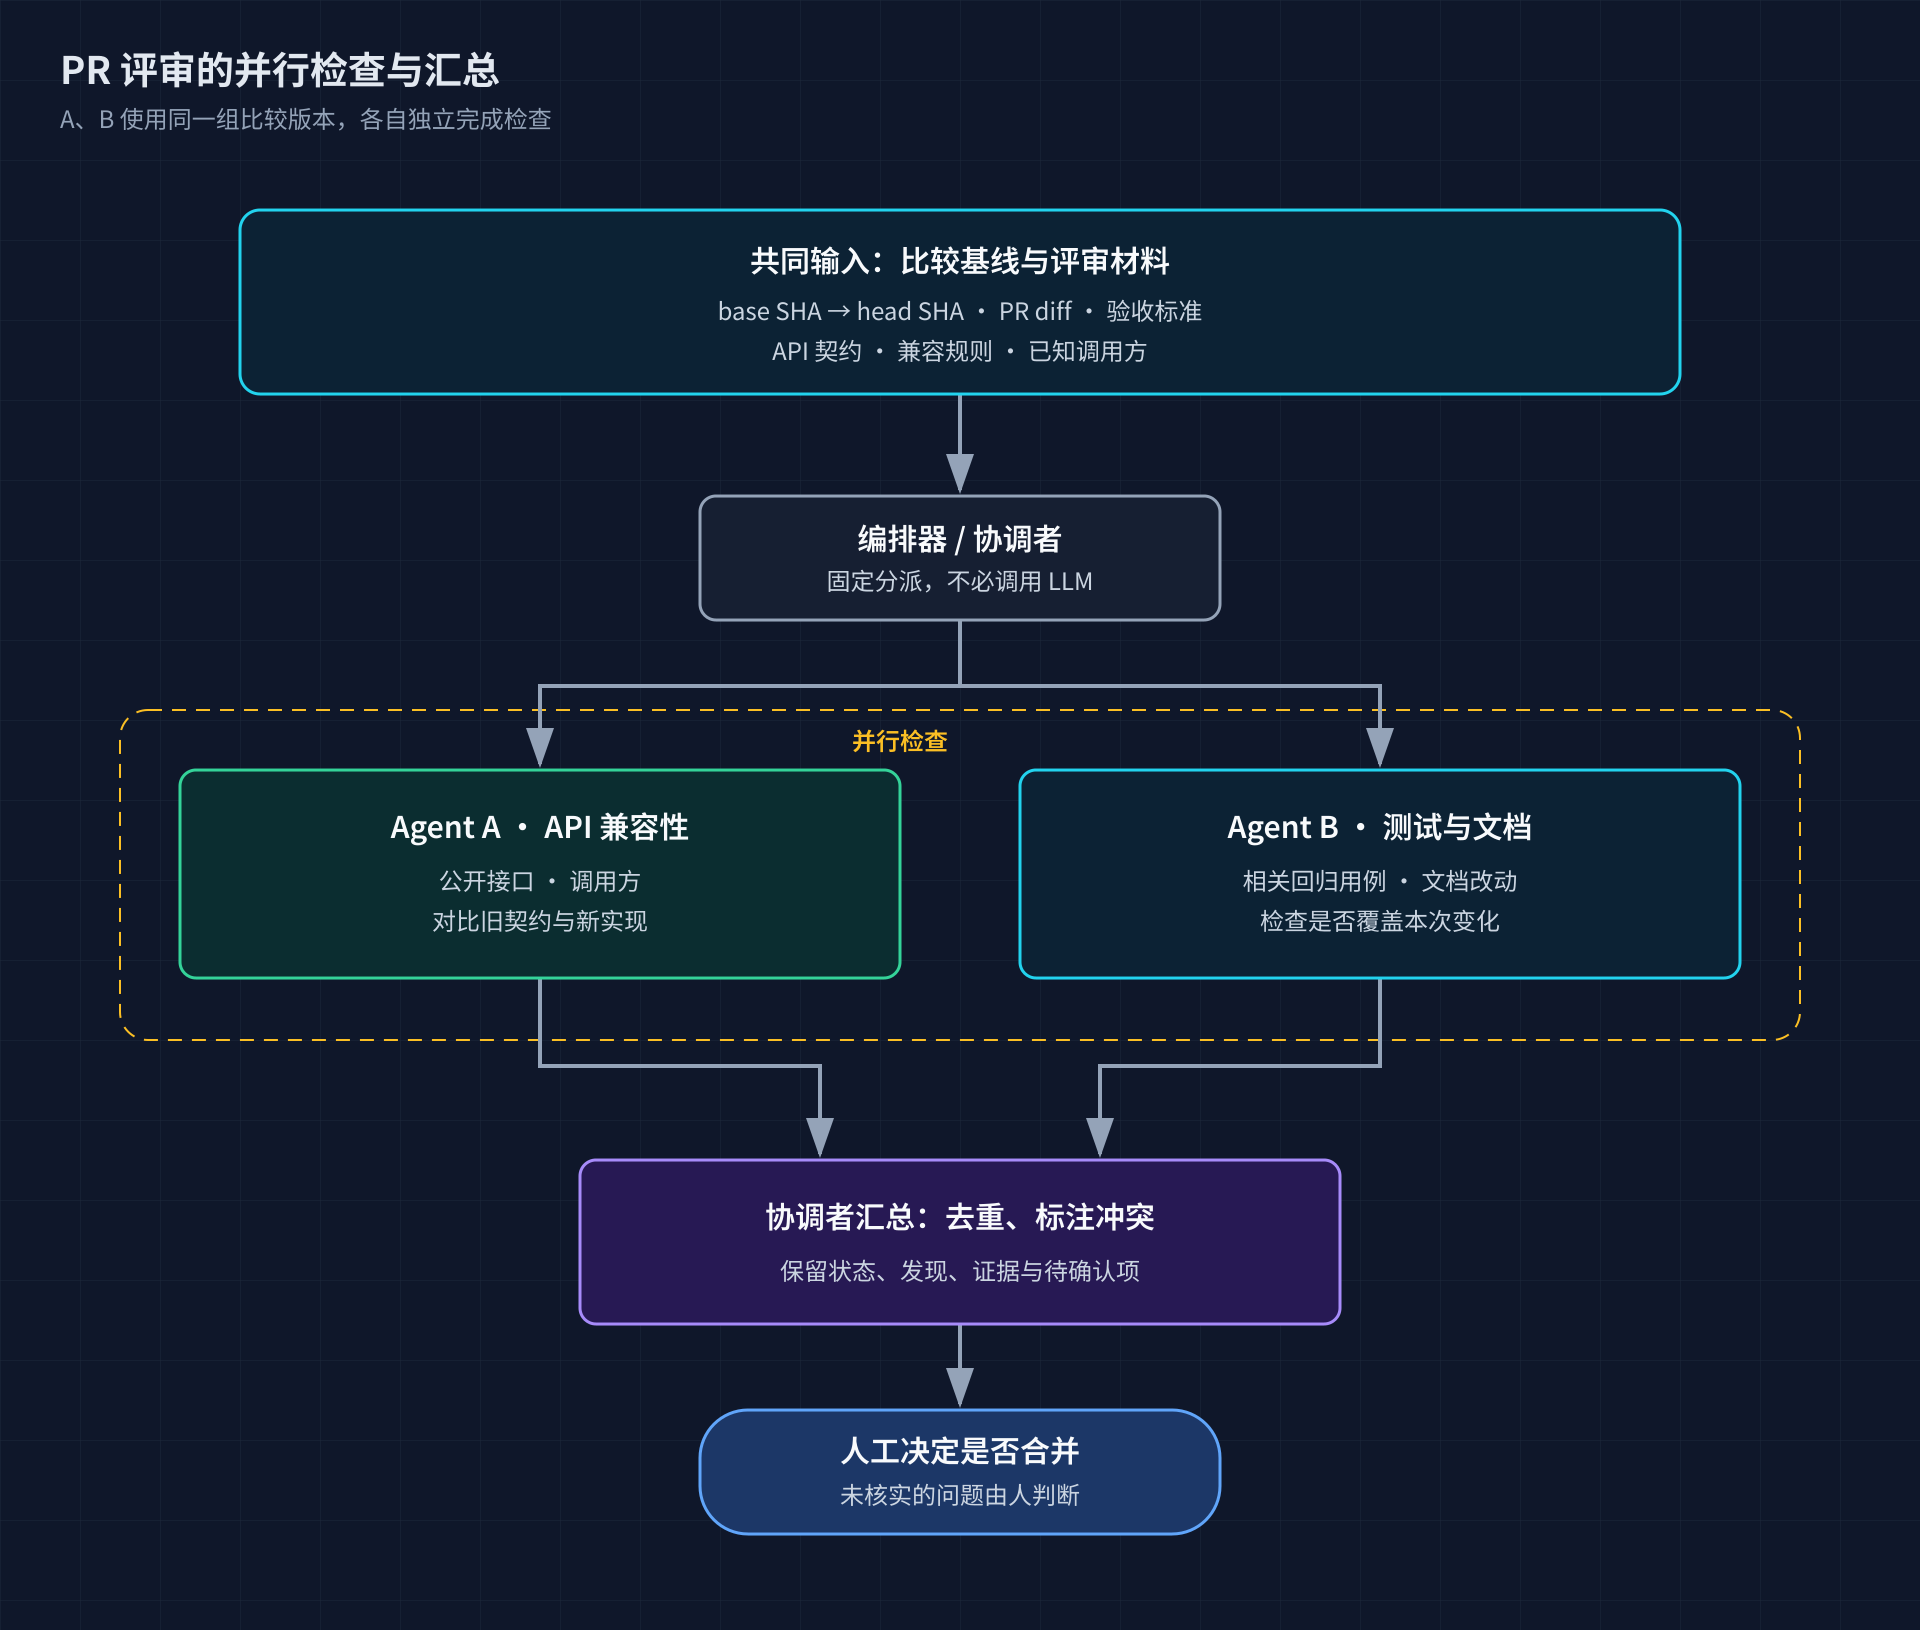
协调者把同一组 base/head 版本和各自需要的材料交给 A、B,两项检查可以独立进行。A 关注公开接口及其调用方,B 关注相关回归用例与文档;它们不必共享全部对话历史。这里的协调者可以是普通程序,不必再增加一个 LLM Agent。
交接结果可以短,但不能只写“看起来没问题”。例如,A 的一条结果记录可以采用下面的格式:
检查项:API 兼容性
版本:<base SHA> → <head SHA>
状态:已检查·有发现 / 已检查·无发现 / 未完成
发现:<具体变更及可能受影响的调用方>
证据:<接口契约、文件位置或测试结果>
待确认:<仅凭当前材料无法判断的条件>
B 也按相同字段返回。这样,“已检查但没发现问题”和“没有检查完”不会混在一起。协调者合并重复发现,给相互矛盾的结论标出各自证据;无法核实的地方保留给人判断,而不是替人选一个答案。
这里也不必把每一步都包装成 Agent。运行测试、读取 diff、定位文件是确定性操作,直接交给工具更合适。Agent 的位置在于解释材料和判断风险,而不是替代测试命令。
并行收益和交接成本都要算
上下文隔离能让每个 Agent 只处理与当前检查有关的材料,不必把两项检查的中间过程塞进同一段模型上下文。并行处理也可能缩短等待时间:如果 A 和 B 真能独立运行,关键路径大致由较慢的那项检查,加上分派与汇总时间决定,而不是两项检查耗时相加。LangChain 的 Subagents 文档说明了这种隔离与并行调用方式。
如果换一个任务,B 必须等 A 的结论才能开始,就没有这部分并行收益。若协调者反复要求重做,两项检查又都消耗模型调用,总耗时和 token 成本也可能高于单 Agent。这里不存在通用的“多几个 Agent 就快几倍”的公式。
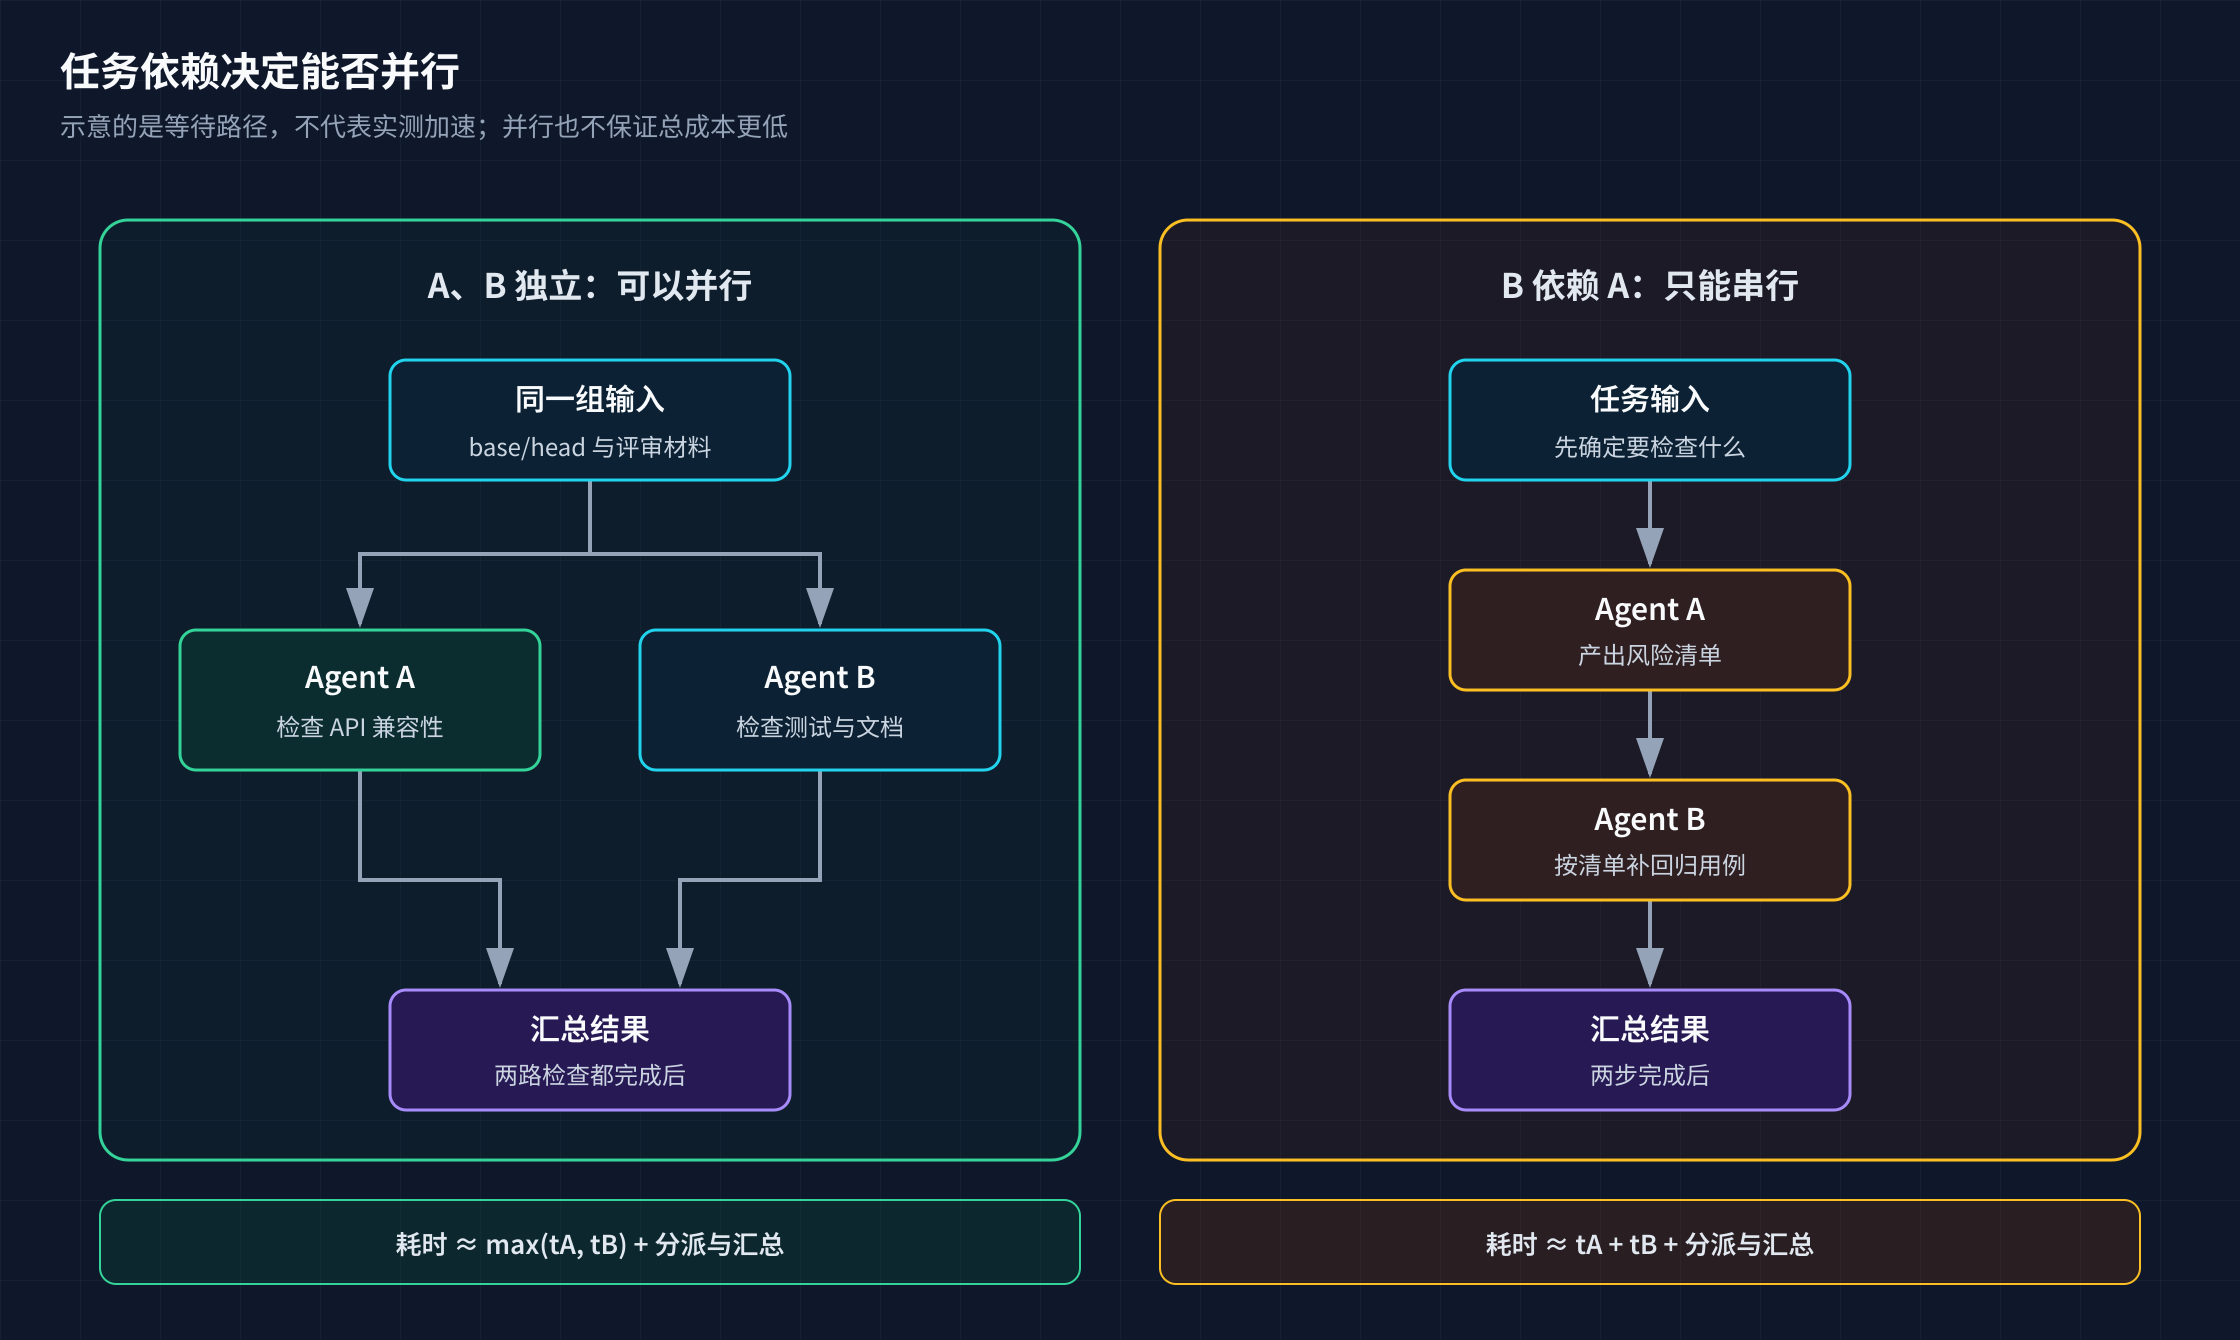
交接是更容易被低估的成本。A 发现某个接口变更可能影响旧客户端,协调者需要知道的是哪一个接口、比较的是哪些版本、证据在哪里,而不是 A 的整段推理记录。传得太少,汇总时容易误解;传得太多,上下文隔离的收益又会消失。
共享状态也需要明确写入规则。以 LangGraph 为例,节点可以更新 State,同一字段的更新怎样合并由 reducer 决定。没有配置 reducer 时,后续步骤的新值会替换旧值;若并行节点在同一步写入同一字段,LangGraph 则会报错。State 提供数据流转机制,并不会自动保证业务信息始终一致。参见 LangGraph 的状态文档和并行更新错误说明。
再往后还有重试与排错:某个检查超时后,是只重跑这一项,还是重跑整个流程?如果两次结果来自不同 commit,还能不能汇总?至少要能追踪每个 Agent 收到的输入版本、调用了什么工具、返回了什么证据。问题未必“指数级”变难,但排查范围确实从单条执行链扩展到了多条链及其交接处。
是否值得这样拆,最好用同一批 PR 和相同的验收标准与单 Agent 做对照:人工确认的有效发现有多少、误报有多少、出结果需要多久、模型调用花费多少。没有这些记录,就不要把一次运行较快当成架构上的普遍优势。
编排方式按任务关系选
对上面这次 PR 评审,分工和依赖关系已经确定:程序并行分派 A、B,收齐结果后汇总,再交给人决定。固定流水线或有向图就够了,无需 LLM 协调者。只有下一步由谁处理必须根据中途结果动态决定时,才需要考虑 supervisor 或 handoff。框架是实现这种关系的工具,不应反过来决定任务怎么拆。
最后回到任务本身
这次 PR 评审能拆成两路,前提是 A、B 可以独立检查、使用同一组比较版本,并交出能被汇总的结果。如果检查高度依赖,或者连输入与输出都说不清,先整理单 Agent 的工具和工作流程,比增加角色更有用。